
Vous demandez à une intelligence artificielle de vous expliquer la présidentielle 2027. En quelques secondes, elle sélectionne des noms, les classe et résume leurs chances. Un baromètre Angie-Meteoria montre que cette sélection varie selon les services interrogés. Avant même de comparer les programmes, l’électeur découvre ainsi une campagne dont l’assistant a déjà organisé la présentation.
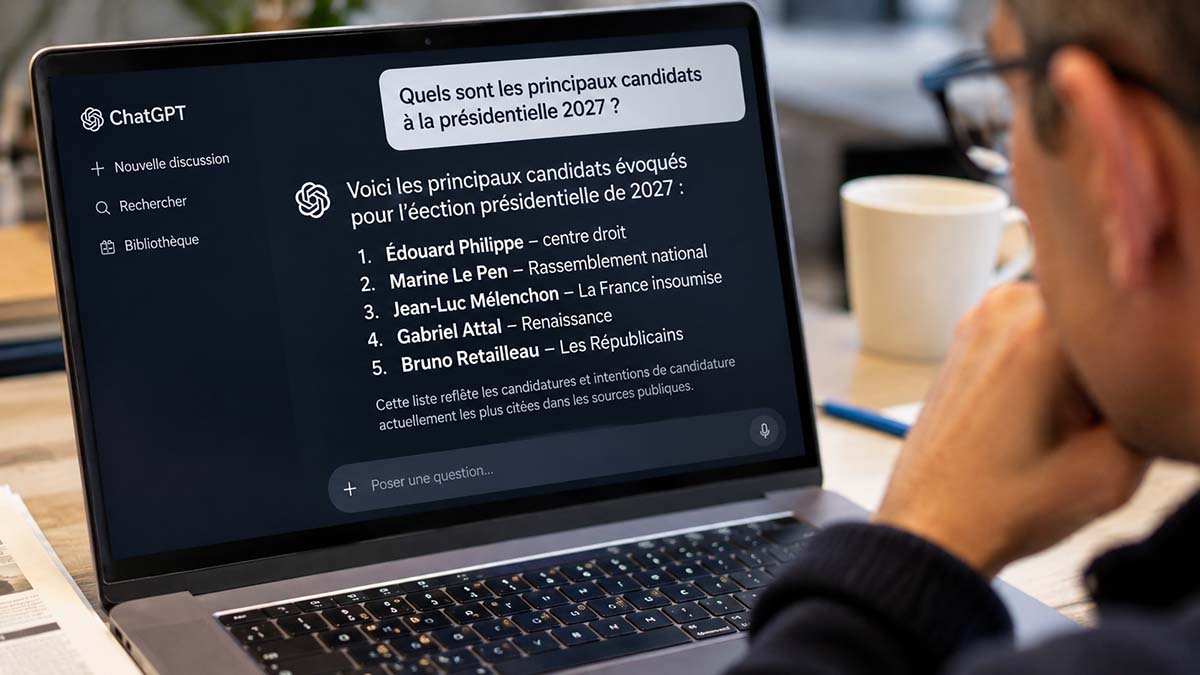
Vous suivez la politique de loin. Pour préparer votre choix, vous ouvrez un assistant et lui demandez quels sont les principaux candidats à la présidentielle de 2027. La réponse arrive sous une forme pratique : quelques noms, des étiquettes politiques et une courte explication pour chacun.
Cette scène ordinaire contient plusieurs décisions. Quels candidats retenir ? Dans quel ordre les présenter ? Quelle place accorder aux sondages, aux programmes et aux déclarations récentes ? Le texte paraît fluide, mais sa lecture mérite les mêmes questions qu’un article ou une émission.
Sept services interrogés pendant un mois
Pour leur première vague publiée en octobre 2026, Angie et Meteoria ont soumis quotidiennement 70 questions à sept services pendant septembre. ChatGPT, Claude, Gemini, Microsoft Copilot, Perplexity, Google AI Mode et Google AI Overview figurent dans le protocole. Environ 15 000 réponses ont été analysées.
Les auteurs ont notamment relevé les mentions de candidats, la tonalité des réponses et les liens cités. Ils précisent que l’étude ne mesure pas les intentions de vote des Français et ne cherche pas à prédire le résultat du scrutin. Les réponses des différents services ne sont pas pondérées par leur fréquentation : le résultat global décrit donc le corpus étudié, sans représenter l’exposition réelle de tous les utilisateurs.
Ce point est essentiel pour lire les pourcentages. Une personnalité présente dans 85 % des réponses à une question bénéficie d’une forte visibilité dans ce test. Ce chiffre ne signifie pas que 85 % des électeurs la connaissent, l’apprécient ou envisagent de voter pour elle.
Les noms qui reviennent, et ceux qui arrivent d’abord
À la question demandant de classer les cinquante principaux candidats par importance, Édouard Philippe et Marine Le Pen sont mentionnés dans 85 % des réponses, Jean-Luc Mélenchon dans 83 %. Bruno Retailleau et Gabriel Attal suivent, avec respectivement 75 % et 74 %. Ces résultats décrivent les réponses recueillies en septembre, dont la situation politique doit être datée.
Le rang d’apparition apporte une autre information. Lorsqu’elle est citée, Marine Le Pen figure en moyenne à la 1,6e position, Édouard Philippe à la troisième et Gabriel Attal à la 3,9e. La fréquence de présence et l’ordre de présentation mesurent donc deux dimensions différentes de la visibilité.
Pour un lecteur pressé, les premiers paragraphes peuvent constituer l’essentiel de la réponse consultée. Le classement fournit alors un cadre de découverte : certains noms ouvrent la lecture, d’autres demandent de poursuivre. Le baromètre permet d’observer cette hiérarchie ; il faudrait une étude auprès des utilisateurs pour mesurer ce qu’ils retiennent et les conséquences sur leurs préférences.
Le mot « important » contient déjà plusieurs critères
La question posée par les chercheurs mérite elle-même un examen. Demander cinquante candidats classés du plus important au moins important oblige l’assistant à interpréter l’importance. Elle peut renvoyer aux intentions de vote, à la notoriété, à l’implantation partisane, à l’expérience ou à la capacité de mobiliser des soutiens.
Ces critères peuvent conduire à des listes différentes. Une personnalité très médiatisée peut être facilement citée sans disposer d’une candidature confirmée. Un candidat déclaré peut, à l’inverse, bénéficier de peu de couverture et apparaître plus loin. Les critères retenus devraient donc accompagner la liste pour que le lecteur puisse en discuter la pertinence.
La demande de cinquante noms élargit aussi considérablement le champ. Pour apprécier une réponse, il faut vérifier le statut de chacun : candidature annoncée, participation à une primaire, hypothèse ou simple nom régulièrement évoqué. Une présentation utile conserve ces distinctions au lieu de donner à toutes les personnalités le même statut.
Les « favoris » changent selon l’assistant
Le rapport pose également une question sur les candidats ayant le plus de probabilités d’être élus. Édouard Philippe apparaît parmi les favoris dans 100 % des réponses, Marine Le Pen dans 99 % et Jean-Luc Mélenchon dans 95 %. Plusieurs noms pouvant être cités ensemble, ces chiffres expriment des fréquences de mention.
Les écarts entre services deviennent particulièrement visibles pour Raphaël Glucksmann. Il figure parmi les favoris dans 100 % des réponses de ChatGPT et 97 % de celles de Gemini, contre 44 % pour Claude et 6 % pour Perplexity. Pour un électeur utilisant un seul service, la liste reçue pourrait donc varier sensiblement dans les conditions de ce test.
Ces différences appellent une analyse des réponses complètes. Un assistant peut expliquer ses réserves, proposer une liste longue ou mentionner plusieurs scénarios. Compter les noms permet de repérer un écart ; lire les arguments permet de comprendre ce qu’il signifie.
Les médias restent présents derrière la synthèse
Les auteurs ont recensé 168 481 occurrences de sources, correspondant à 18 686 pages et 1 616 domaines uniques. Dans cette collecte, 49 % des liens cités renvoient à la presse et aux médias. Le domaine du Monde représente 15 % de l’ensemble.
La réponse générée fait ainsi souvent circuler des informations déjà publiées ailleurs. Elle peut en faciliter l’accès en rassemblant des éléments dispersés. Le lecteur doit cependant pouvoir retrouver les textes, leurs dates et leurs précautions pour vérifier comment la synthèse a été construite.
Les liens visibles n’expliquent pas intégralement la production d’une réponse. Ils ne permettent pas, à eux seuls, de reconstituer toutes les informations mobilisées ni de mesurer le rôle exact de chaque source. Leur analyse renseigne surtout sur ce que le service cite à l’appui de son propos.
Une sélection peut renforcer une visibilité existante
Un candidat souvent commenté dispose d’un grand nombre de textes à son sujet. On peut formuler l’hypothèse que cette abondance contribue à sa présence dans les synthèses, qui deviennent à leur tour une porte d’entrée vers sa candidature. Le baromètre observe des hiérarchies compatibles avec cette question, sans isoler toute la chaîne qui les produit.
Cette distinction évite de prêter une intention politique à chaque classement. Une réponse peut refléter les sources disponibles, le sens donné à la question et les conditions techniques du service. Pour identifier un traitement injustifié, il faudrait comparer les informations pertinentes disponibles avec celles effectivement retenues.
Le phénomène intéresse déjà les campagnes. Reuters a documenté, aux États-Unis, des démarches visant à adapter les contenus politiques aux moteurs génératifs utilisés par des électeurs. Cette stratégie cherche à améliorer la présence dans les réponses ; ses effets sur les votes restent une question distincte.
Ce que le baromètre laisse encore à vérifier
Répéter les questions pendant trente jours permet d’observer davantage qu’une réponse isolée. Mais les résultats restent attachés à une période et à un protocole. Les services évoluent, l’actualité change, et les conditions d’accès aux sources peuvent modifier les textes produits.
Pour reproduire précisément l’expérience, il faudrait disposer des versions interrogées, des réglages, des conditions de recherche web et des règles de codage des réponses. Les questions figurent dans les annexes ; la description publiée ne détaille pas l’ensemble de ces paramètres. Les sept services comprennent par ailleurs des produits distincts d’un même fournisseur, ce qui mérite d’être considéré lorsqu’on interprète leur convergence.
Enfin, les auteurs exercent dans la communication et la visibilité numérique. Ce contexte rend leur démarche compréhensible et appelle la même exigence de transparence que toute étude utilisée dans le débat public. Leurs observations gagnent à être confrontées à d’autres protocoles et à des recherches sur les usages des électeurs.
Comment garder la main sur sa découverte des candidats
Une question plus précise donne au lecteur davantage de prises sur la réponse. Il peut demander de distinguer les candidatures déclarées des hypothèses, de dater les informations et d’expliquer les critères du classement. Il peut ensuite vérifier quelques noms et propositions dans les sources originales.
Comparer deux services peut révéler des différences, à condition de lire leurs justifications. Une convergence peut aussi provenir de sources communes. Pour examiner un programme, demander le texte officiel et la date de la mesure aide à séparer la proposition de son commentaire.
L’assistant peut ainsi servir à organiser une première recherche, préparer des questions et retrouver des documents. Le travail de l’électeur consiste ensuite à examiner ce que la sélection met en avant et ce qu’elle laisse de côté. Avant de demander quel candidat paraît le mieux placé, une question mérite donc d’être posée : selon quels critères, et à partir de quelles informations ?
À lire aussi sur Mundopolys
- Ados et IA : quand l’intelligence artificielle aide à apprendre… ou apprend à leur place
- Information : quand le sensationnalisme transforme un fait réel en phénomène de société
- Politique : quand faire le buzz devient plus important que débattre